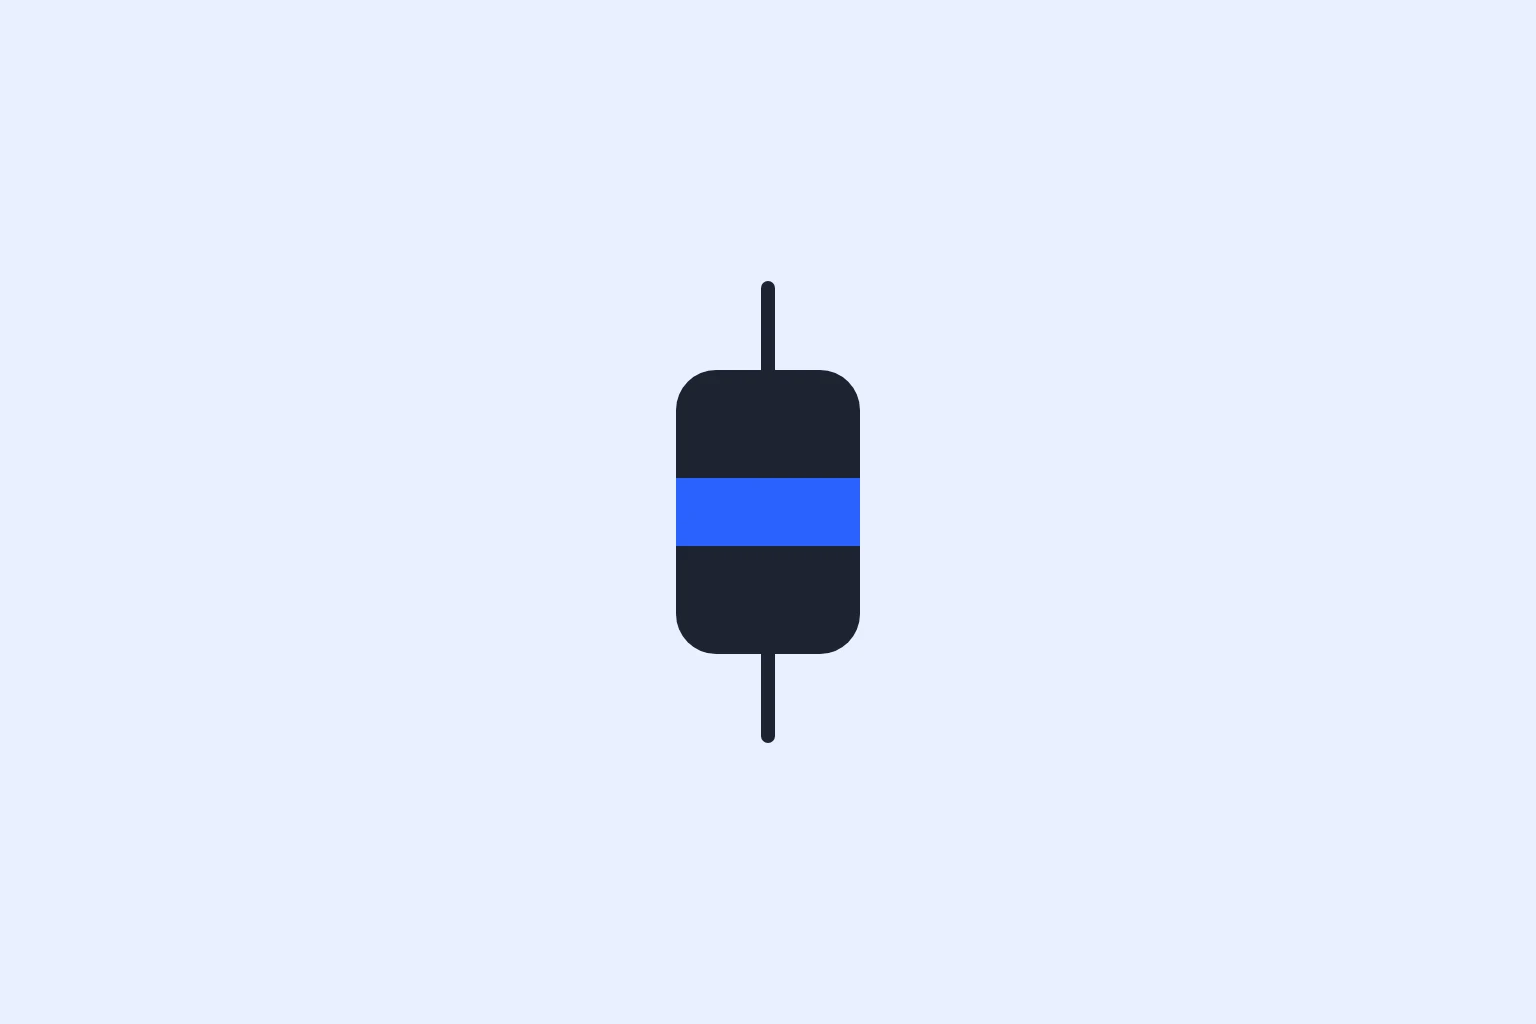
這裡有一根 K 線。Binance USDⓈ-M 永續合約,BTCUSDT,UTC 13:46:00 開始的那一分鐘。它從 klines endpoint 回傳時,只是一個由十二個值組成的裸陣列,也是零售及其周邊量化研究中最常見的輸入單位。我們產生的策略幾乎都會碰到這種形狀的資料。
所以,讓我們按照索引逐一拆解,看看回測究竟會把多少事情弄錯。
| 索引 | 值 | 名稱 |
|---|---|---|
| 0 | 1773495960000 | 開盤時間(毫秒) |
| 1 | "84120.50" | 開盤價 |
| 2 | "84177.90" | 最高價 |
| 3 | "84098.10" | 最低價 |
| 4 | "84163.40" | 收盤價 |
| 5 | "38.417" | 基礎資產成交量(BTC) |
| 6 | 1773496019999 | 收盤時間(毫秒) |
| 7 | "3232108.94" | 計價資產成交量(USDT) |
| 8 | 1204 | 成交筆數 |
| 9 | "21.883" | taker 買入基礎資產成交量 |
| 10 | "1841203.55" | taker 買入計價資產成交量 |
| 11 | "0" | 忽略 |
[0] 和 [6]:這是哪一分鐘?又是誰的時鐘?
開盤時間是 1773495960000,收盤時間是 1773496019999。注意第二個數字:它以 19999 結尾,比下一根 K 線的開盤時間早一毫秒。這個時間窗是左閉右開的,而交易所明確地告訴了你這件事。我追查過的一半資料錯誤,都始於有人把兩個端點都當成包含在內,導致邊界上的成交被重複計算;或者重新取樣時對不齊,讓每根 5 分鐘 K 線從鄰近 K 線借來一毫秒。
這些時間戳是交易所撮合引擎的時間。不是你的時鐘,不是供應商的資料接收時鐘,也不是 funding snapshot 所使用的同一個時鐘。當你把 K 線序列與 funding-rate 序列,或從不同 endpoint 拉取的未平倉量序列合併時,你其實是在合併彼此通常只能精確到大約一秒的資料來源。對 1 分鐘策略而言,這代表每一列合併資料都有 1.7% 的時序誤差。對任何次分鐘級策略來說,這是致命的。
而這根 K 線標記的是它的 開盤時間。裡面的資訊要到 13:46:59.999 才能知道。每一個索引慣例問題——我要不要往後移一根、該把 K 線收盤還是開盤時間當作事件時間——其實都是同一個穿著不同外衣的前視偏誤問題。
[1] "84120.50":你無法交易到的開盤價
開盤價是時間窗內第一筆成交的價格。那是一筆發生在其他兩個人之間、已經完成的交易。等到這根 K 線以一列資料出現在你的 dataframe 裡時,那個價格已經是六十秒前的事了。
前一根 K 線收在 84109.80,所以相鄰兩根 1 分鐘 K 線之間的缺口裡,存在 $10.70 的價格變動。這是 1.3 個基點,在圖表上看不出來,大約是 taker 手續費的四分之一。沒問題。但去看看美國 CPI 公布時同一序列中的某個山寨幣永續合約,那些 K 線之間的缺口會達到 15 到 40 bps。以 K 線收盤發出訊號、在下一根 K 線開盤成交的回測,悄悄假設這個缺口為零;而它偏偏只在缺口不該為零的時候才是零。
[2] 和 [3]:"84177.90" 最高價、"84098.10" 最低價
大多數成交引擎都會在這兩個欄位上走向毀滅,所以這一節會比較長。
最高價和最低價只是極端的 觸及價格。它們不包含成交量,也不包含持續時間。從同一分鐘的原始成交明細來看,84100.00 或以下的所有成交,在 1.4 秒的時間窗內分成九筆,總量只有 0.62 BTC。因此,回測在 84100 的停損會「成交」——如果你的部位是 3 BTC,你在下跌途中吃掉了整個可見的訂單簿,剩餘數量則會在 84105–84130 的回彈路徑上成交。K 線告訴你最低價是 84098.10,卻沒有告訴你那裡實際成交的名目金額只有 $52,000。
另一個方向更糟,因為它會讓你產生錯誤的自信。假設你在 84175 掛著限價賣單。K 線最高價是 84177.90,因此天真的引擎會在 84175 幫你成交,並記入 maker 回饋,而不是 taker 成本。這筆成交是否真的發生,取決於你在該價位的佇列位置;K 線不可能知道,而你大概也從未記錄過。觸及不等於成交。
我們在成交引擎中確立的規則是:只有當 K 線 穿越該價位,而不只是觸及該價位時,掛著的限價單才會成交。在恰好等於極端價位的成交,必須有成交明細中的價量證據,否則一律拒絕。這項規則讓典型均值回歸帳本少了約 6% 的成交,也把其中一個候選策略的回測 Sharpe 從 1.9 降到 1.1。那個候選策略從來就不是真實的;只是成交規則終於誠實到足以說出這件事。
另一個相關陷阱是 K 線內路徑。如果一根 K 線的波動範圍同時涵蓋你的停損和止盈,OHLCV 無法告訴你哪一個先發生。每個引擎都必須選定一套慣例。我們的引擎一律假設先觸發停損:這很悲觀、偶爾會錯,但絕不會憑空製造一場假勝利。如果你的引擎假設先止盈,大波動 K 線就會從歧義中製造利潤;而大波動 K 線恰恰是主導你 PnL 分布的那些 K 線。
[4] "84163.40":這根 K 線裡最不穩健的數字
收盤價是時間窗內最後一筆成交。就這樣。它可能只是某個 bot 在 13:46:59.8 為了補足部位而成交的 0.002 BTC 零碎單。這個結構上任意的單一 tick,卻是大多數研究流程用來計算每個訊號、標記每個部位,以及評估每個出場的依據。
在 BTC 永續合約上,這件事影響不大;但在 UTC 04:00 流動性稀薄的山寨幣永續合約上,影響就非常巨大。同一分鐘裡,兩家交易所的收盤價差異甚至可能超過你每筆交易的全部 edge。當某個策略的 PnL 特別依賴收盤價時,我們會改用交易所標記價格重新執行;那個價格源自指數,更難被操弄。如果結果出現分歧,就代表該策略交易的是資料瑕疵。
[5] 和 [7]:"38.417" 與 "3232108.94",成交量的單位究竟是什麼?
基礎資產成交量是 BTC;計價資產成交量是 USDT。這裡兩者都有,算是交易所提供的貼心服務,但不是所有交易所都會提供。之所以需要在意,是因為你要跨交易所進行聚合。以幣本位合約來說,報價單位是每張 $100 名目金額的合約。有些股票資料源回報的是 round lot。預測市場交易所回報的是股份數,而一股代表一個以美元計價的二元主張。若未將單位正規化為單一名目金額,就直接把混合市場中的「成交量」相加,得到的流動性排名純粹是胡說八道;而且它會以一種看似穩定、足以通過審查的方式持續胡說八道。
在資料匯入時,將所有數值正規化為計價資產名目金額。原始欄位也要保存,但絕不能讓策略看見它。
[8] 1204:應該用來設定你的衝擊模型的欄位
用基礎資產成交量除以成交筆數,得到平均每筆成交量 0.032 BTC,約 $2,700。如果你的候選策略想一次進場 $250,000,它要求的規模大約是該分鐘典型交易的 92 倍。應該驅動平方根衝擊項的,正是這個數字,而不是某個通用的 5-bps 滑價常數。我們會將每根 K 線的參與率作為一等欄位計算,並拒絕那些中位數進場量超過 K 線名目金額幾個百分點的策略,因為再往下的所有東西都是虛構。
成交筆數也能便宜地標記出異常的分鐘。成交量正常,但成交筆數跌到 11?有人做了一筆大宗交易。成交量正常,但成交筆數達到 9,000?那是清算瀑布被拆成一小筆一小筆地吞掉。
[9] 和 [10]:"21.883",大家都會丟掉的欄位
taker 買入基礎資產成交量。這根 K 線的 38.417 BTC 中,有 21.883 BTC 是由買方主動發起,因此帶符號的成交量差為 +5.349 BTC,主動方比例則是買方 57%、賣方 43%。交易所免費把訂單流失衡交給你,放在一個大多數人從未讀取的欄位裡,因為 pandas 沒有替他們命名這個欄位。
我不是說它本身就能預測報酬;天真的差值策略,是把錢捐給手續費帳本最可靠的方法之一。但這確實是與價格不同的測量值,它就在你原本已經發出的同一個請求裡,而且能讓你區分一場由買盤推動的上漲,和一場因賣方退開而發生的上漲。這兩者在 OHLC 上看起來一模一樣,十分鐘後的表現卻不同。我們的研究 agent 會把這件事視為:在某個交易所公開提供 taker 買賣分布時,忽略它的假說等於把證據留在桌上。
[11] "0":忽略——以及這裡沒有的其他所有東西
索引 11 是已棄用的欄位,永久為零。更有意思的是,這根 K 線沒有包含的東西:沒有 bid、沒有 ask、沒有價差、沒有訂單簿深度、沒有 funding rate、沒有未平倉量、沒有清算、沒有標記價格、沒有指數價格。更關鍵的是,它無法告訴你 你的訂單會是 maker 還是 taker,而這正是你在這個交易所支付 0.045% 或賺取 0.01% 之間的差別。
因此,任何只建立在 klines 上的手續費模型,都是穿著數字外衣的假設。我們的做法是強迫每個策略事先聲明執行風格,然後對所有無法證明是其他情況的交易收取 taker 費用。
從未出現的 K 線
最後一個部分,也是離開主流幣後最容易造成傷害的部分。沒有任何成交的那一分鐘,根本不會產生 K 線。供應商和函式庫通常會對它做 forward-fill:open = high = low = close = 前一根收盤價,成交量為 0。你的指標照樣愉快地計算,策略看到一列有效資料,還能在全世界根本沒有人交易該標的的那一分鐘產生訊號。
在我們匯入的一個中型市值永續合約上,十二個月區間內有 4.1% 的 1 分鐘 K 線沒有任何成交。該標的的一個均值回歸候選策略,有 38% 的進場發生在合成 K 線上,因為平坦的合成價格對任何衡量偏離移動平均程度的東西都極具吸引力。它的回測結果美得不得了。實際上,它交易的是資料中的缺口。
所以現在,匯入層會在每根 K 線上攜帶一個 synthetic boolean,並在每次重新取樣時一路傳遞;驗證關卡則會讓任何交易集中發生在這類 K 線上的策略直接失敗。這是一個成本很低的欄位,卻淘汰了比我們寫過的任何指標都更多的候選策略。
十二個值。其中四個經常被誤讀,兩個經常被丟棄,還有一整類資訊根本不在這一列裡,卻被引擎自行想像出來。下一次回測前,從你自己的資料庫拉出一根原始 K 線,對照你的成交邏輯對它的假設,把每個欄位大聲讀一遍。這只需要二十分鐘,而我從沒見過有人做完後發現什麼問題都沒有。
← 所有文章